Claude Code de graça e ilimitado no PC: como eu fiz (e os limites)
Resposta curta: dá para rodar o Claude Code de graça trocando o modelo da Anthropic por um modelo aberto no seu PC, com o Ollama. Eu fiz no meu Windows e medi: o Gemma criou uma calculadora em 1 min 54 s, e o Qwen3 Coder levou 4 min 45 s porque não coube na placa de vídeo. Funciona para tarefas pequenas; para projeto grande, nenhum dos dois chega perto do Claude pago.
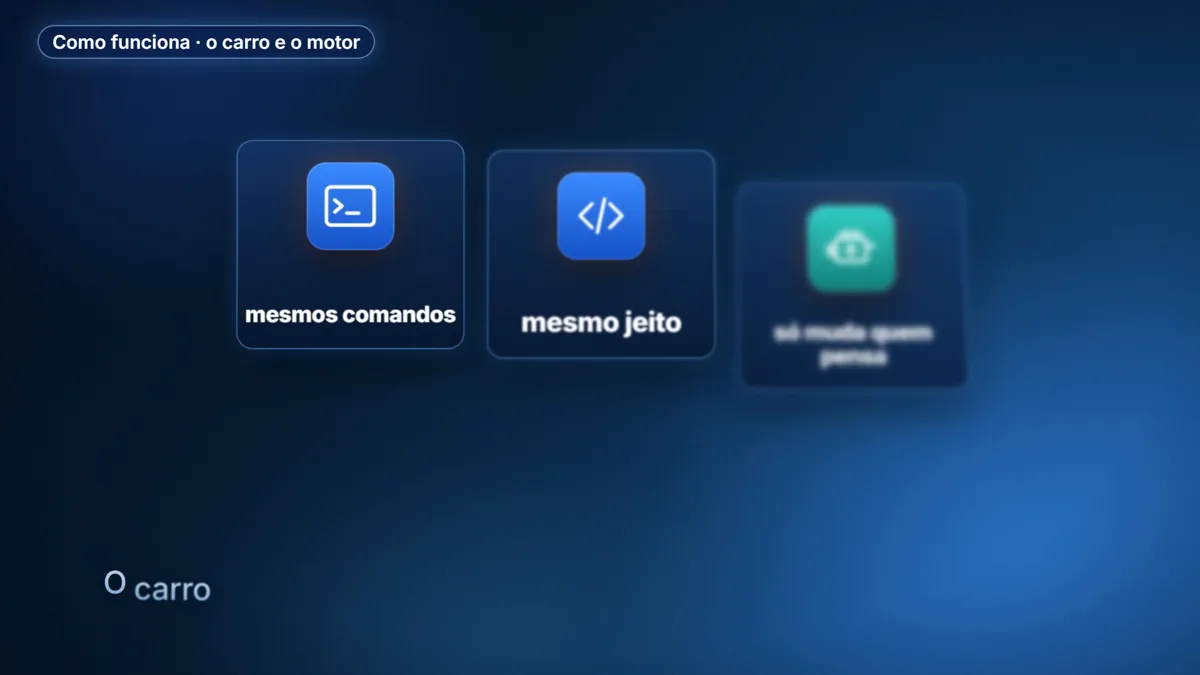
Como funciona: o carro e o motor
O Claude Code é o carro: os comandos, as ferramentas, o jeito de trabalhar. O modelo de inteligência artificial é o motor. As versões novas do Ollama conversam direto com o Claude Code, sem programa no meio, então você troca o motor pago por um grátis rodando na sua máquina. Os comandos continuam os mesmos; só muda quem pensa.
Passo 1: instalar o Ollama e escolher o modelo pela VRAM
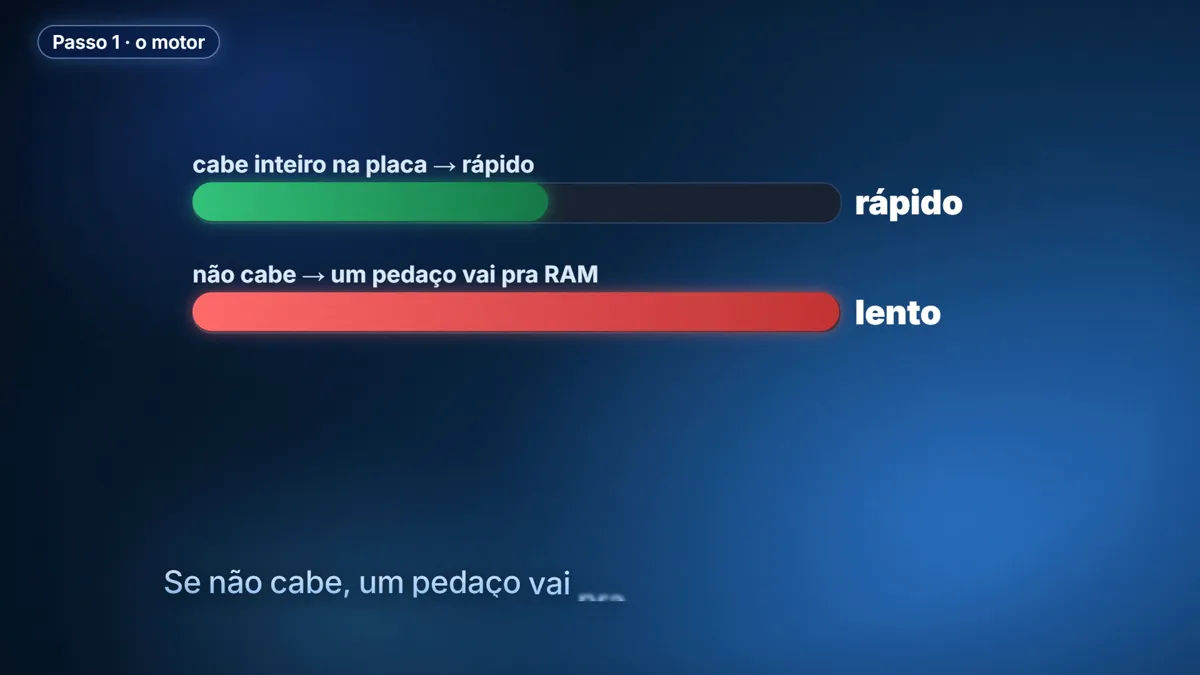
No site do Ollama, baixe o instalador do seu sistema; no meu PC levou menos de 2 minutos. A escolha do modelo depende de um detalhe que pouca gente fala: o que manda é a memória da placa de vídeo, a VRAM. Se o modelo cabe inteiro na placa, roda rápido; se não cabe, um pedaço vai para a RAM e tudo arrasta.
| Meu PC | Valor |
|---|---|
| Processador | Ryzen 9 7900X |
| RAM | 32 GB |
| Placa de vídeo | AMD Radeon RX 7900 XT, 20 GB de VRAM |
| Modelos testados | Gemma e Qwen3 Coder (18 GB) |
Com 32 GB de RAM já dá para um modelo focado em código como o Qwen3 Coder. Eu baixei os dois para comparar.
Passo 2: o ajuste sem o qual nada funciona
O Claude Code manda muita instrução junto com cada pedido. Com o contexto padrão do Ollama isso não cabe, e o modelo nem recebe o que você digitou: o meu respondeu "estou pronto, me diga o que fazer" para um pedido inteiro. A própria documentação do Ollama manda usar 64 mil de contexto. Com esse ajuste, funcionou. A página de cada modelo no site do Ollama mostra o comando pronto para copiar.
Passo 3: o teste de verdade, medido
Mesmo pedido para os dois: criar uma calculadora.
| Teste | Gemma | Qwen3 Coder |
|---|---|---|
| Calculadora (2ª rodada, medida) | 1 min 54 s | 4 min 45 s |
| Por que a diferença | coube na VRAM | com o contexto grande ocupou 20 GB e transbordou |
| Comportamento | entregou | tentou salvar na pasta errada, foi bloqueado e disse que tinha criado |
Esse último ponto importa: o modelo grátis errou e afirmou que tinha feito. É o tipo de coisa que o guia inteiro resume numa frase honesta: é grátis, não é mágica. Para uma calculadora, o Gemma resolve; para projeto grande, nenhum dos dois chega perto do Claude pago.
Os dois caminhos extras que eu testei
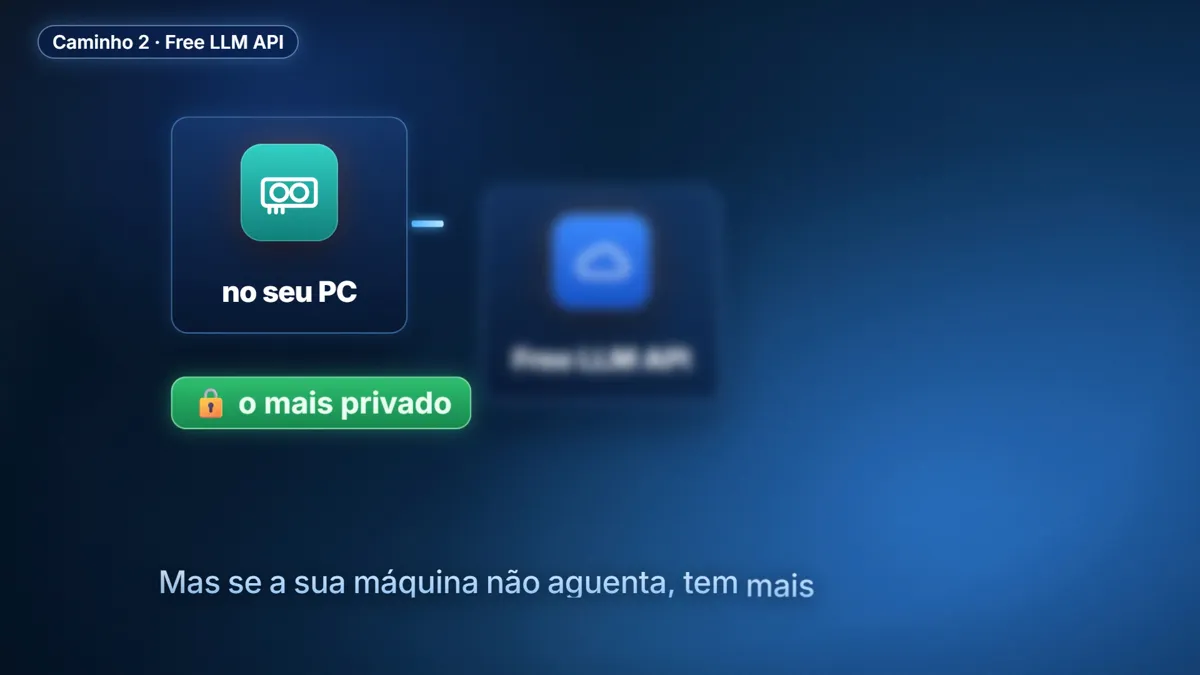
- Free LLM API: quase todo laboratório tem plano grátis (Google, Groq, Mistral). Sozinho, cada um acaba rápido; a Free LLM API junta todos num endereço só e o Claude Code usa esse endereço como motor. A chave mais fácil de conseguir é a do Google AI Studio.
- OpenCode: agente de código grátis e aberto. Os modelos de nuvem dele me responderam "limite grátis atingido", então liguei no mesmo Ollama do meu PC: a mesma calculadora saiu em 1 min 55 s com o Qwen, menos da metade do tempo que o Claude Code levou com o mesmo modelo.
O guia em PDF, de graça
Para você não ter que calcular qual modelo cabe na sua memória e na sua VRAM, eu montei um guia em PDF com o passo a passo completo, a lista de modelo certo para cada máquina e os erros que eu tomei: >pegue o guia aqui (ele chega no seu e-mail).
Isso combina com os guias de usos do Claude e de criar um jogo com IA para a Steam. E tudo roda a partir das skills grátis do Claude para vídeo.
Perguntas frequentes
O Claude Code de graça substitui o pago? Para tarefas pequenas e para aprender, sim. No meu teste, o modelo grátis criou uma calculadora em menos de 2 minutos. Para projeto grande, nenhum modelo aberto que eu testei chegou perto do Claude pago, e um deles chegou a afirmar que tinha salvado um arquivo que foi bloqueado.
Preciso de placa de vídeo boa? Precisa de VRAM suficiente para o modelo escolhido. Na minha RX 7900 XT de 20 GB, o Gemma coube e voou; o Qwen3 Coder de 18 GB transbordou com o contexto grande e ficou 2,5 vezes mais lento. Sem placa, dá para usar o caminho da Free LLM API, juntando planos grátis da nuvem.
Qual é o erro mais comum ao ligar o Ollama no Claude Code? Deixar o contexto padrão. O Claude Code envia instruções longas e o pedido não chega ao modelo. O ajuste é subir o contexto para 64 mil, como a documentação do Ollama recomenda.
Isso serve para fazer vídeo com IA de graça? Serve para a parte de código. Eu usei esse mesmo caminho no meu vídeo dos Shorts animados de graça, com o Gemma escrevendo a história e as cenas no meu PC.